About
Contact
記事
動画
ソリューション
Sign In
検索
Sign In
記事
動画
ソリューション
About
Contact
Top
>
検索結果
1~12 / 56件
ビジネス
2026
/
7
/
31
[FRI]
SpaceXAI、音声エージェント向けAI「Grok Voice Think Fast 2.0」発表 会話能力を強化、初回音声まで0.70秒
マルチモーダルAI
ビジネス
2026
/
6
/
26
[FRI]
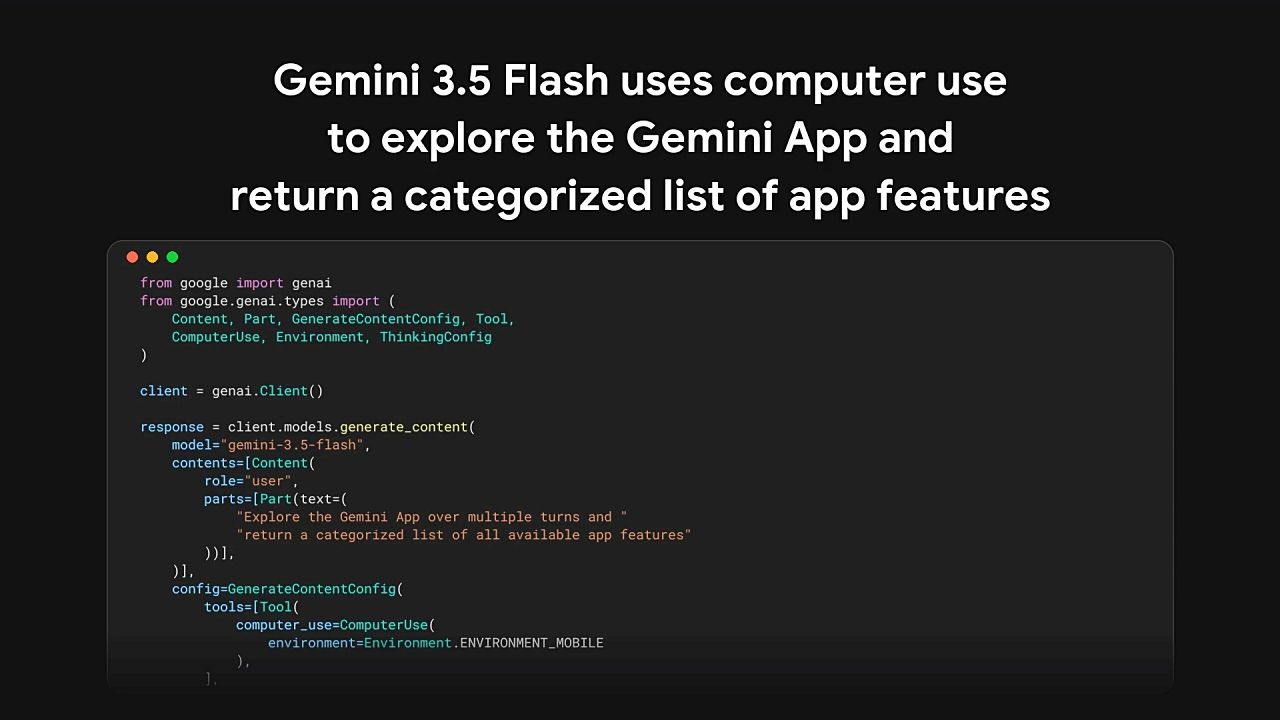
Google、Gemini 3.5 Flashに画面操作機能「Computer Use」を統合 ブラウザ・モバイル・デスクトップ操作に対応
Google
AIエージェント
マルチモーダルAI
ビジネス
2026
/
5
/
20
[WED]
Google I/O 2026開催——最新基盤モデルGemini 3.5 Flash発表 24時間動く個人AIエージェント「Gemini Spark」とマルチモーダルモデルGemini Omniなども公開
Google
基盤モデル
AIエージェント
マルチモーダルAI
ビジネス
2026
/
4
/
10
[FRI]
Meta、Superintelligence Labs初のAIモデル「Muse Spark」発表 Meta AIアプリとWebで提供開始
Meta
基盤モデル
マルチモーダルAI
ビジネス
2026
/
1
/
14
[WED]
リコー、「文書×AI」を現場仕様に──Qwen2.5-VL-32B基盤、視覚データ60万枚でチューニング
マルチモーダルAI
基盤モデル
国内企業事例
ビジネス
2025
/
11
/
15
[SAT]
AIの"ゴッド・マザー" Fei-Fei LiのWorld Labs、マルチモーダル世界モデル「Marble」を一般公開──テキスト・画像・動画から“永続3Dワールド”生成
マルチモーダルAI
基盤モデル
学術&研究
2025
/
10
/
7
[TUE]
Google ResearchとDeepMind、「StreetViewAI」を発表──視覚障害者がAIと対話しながらストリートビューを“歩く”
Google
マルチモーダルAI
エンタメ&アート
2025
/
8
/
2
[SAT]
Runway、動画編集を一新するAIモデル「Aleph」発表──物体除去から新アングル生成まで
マルチモーダルAI
エンタメ&アート
2025
/
4
/
25
[FRI]
Adobe、生成AI基盤「Firefly」を刷新——画像・動画・音声・ベクターを統合し、OpenAI・Googleモデルも選択可能に
マルチモーダルAI
ビジネス
2025
/
4
/
17
[THU]
OpenAI、推論特化型の新モデル「o3」「o4-mini」を同時リリース——画像を“思考”に組み込み、全ツールを自律的に呼び出す
AIエージェント
OpenAI
マルチモーダルAI
基盤モデル
ビジネス
2025
/
4
/
7
[MON]
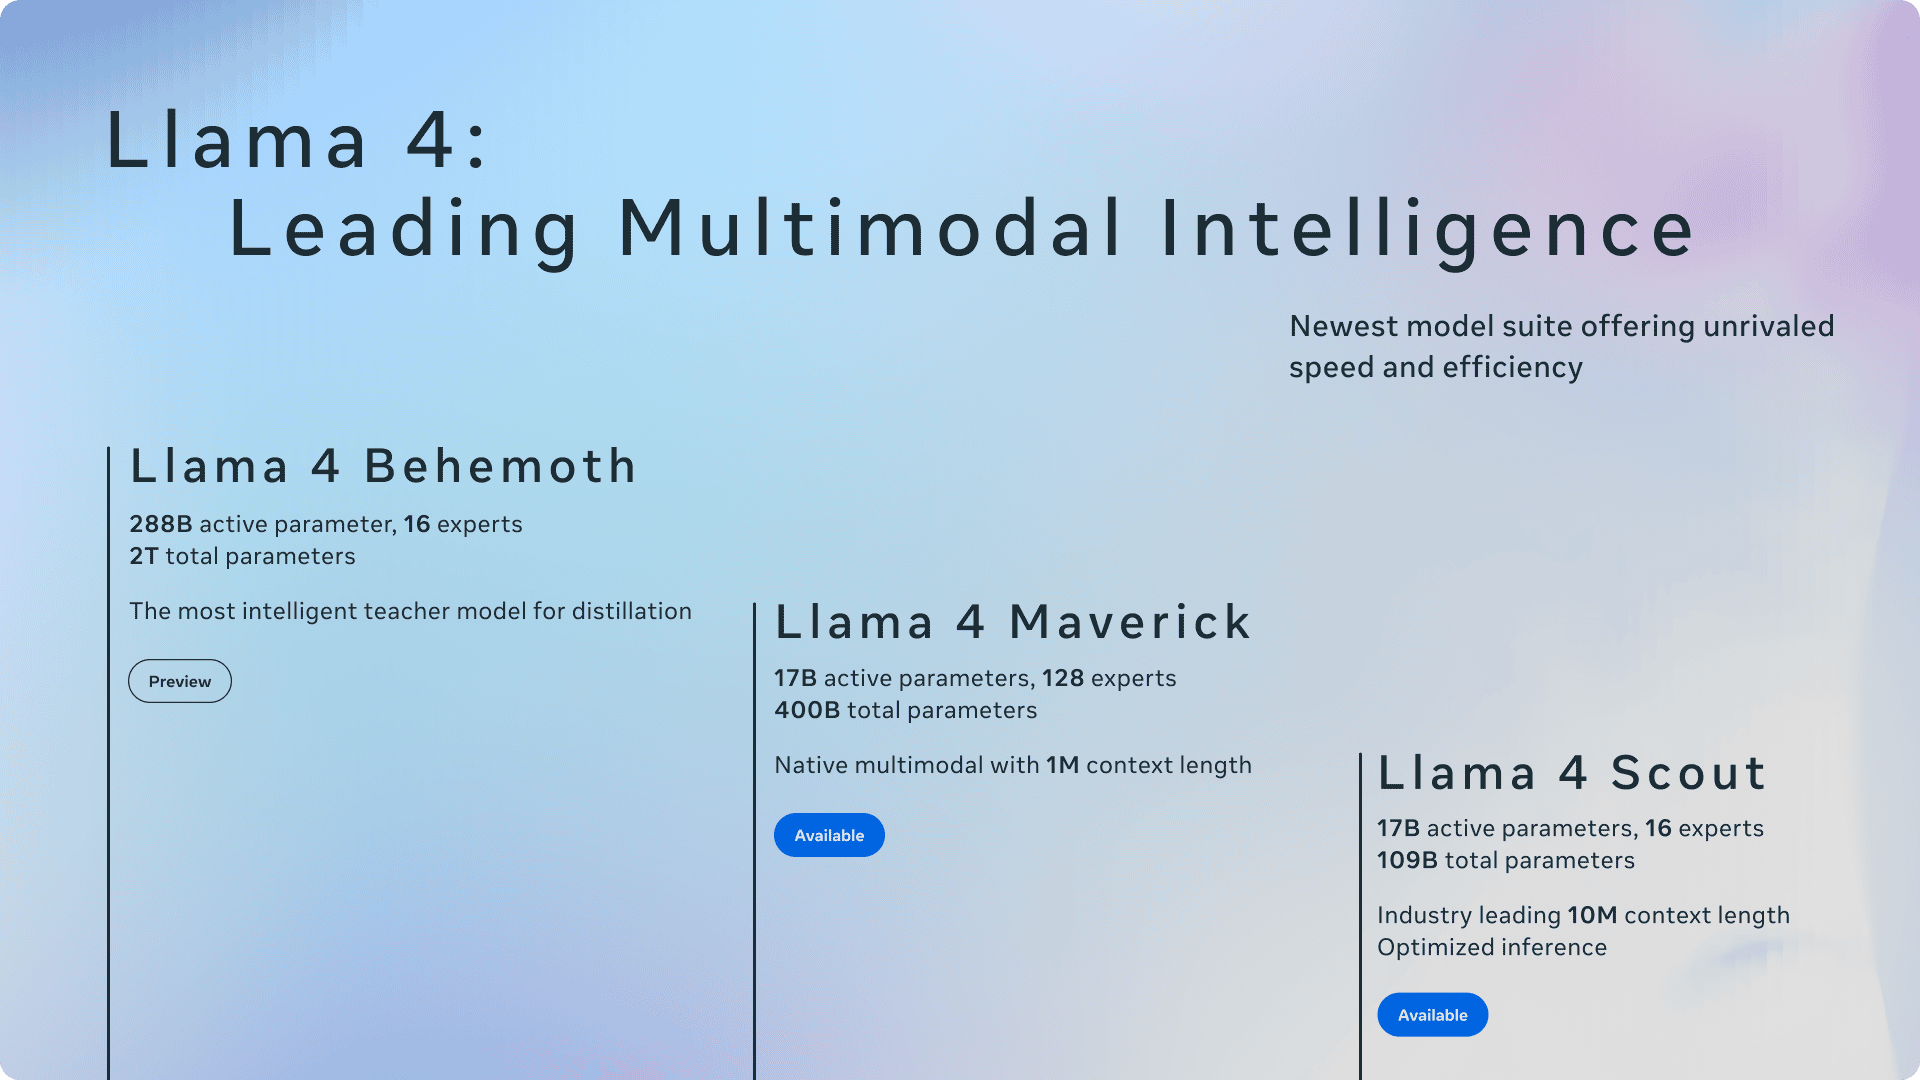
Meta、「Llama 4」発表 オープンウェイトで進化するネイティブマルチモーダルAIの可能性
Meta
マルチモーダルAI
基盤モデル
学術&研究
2025
/
4
/
3
[THU]
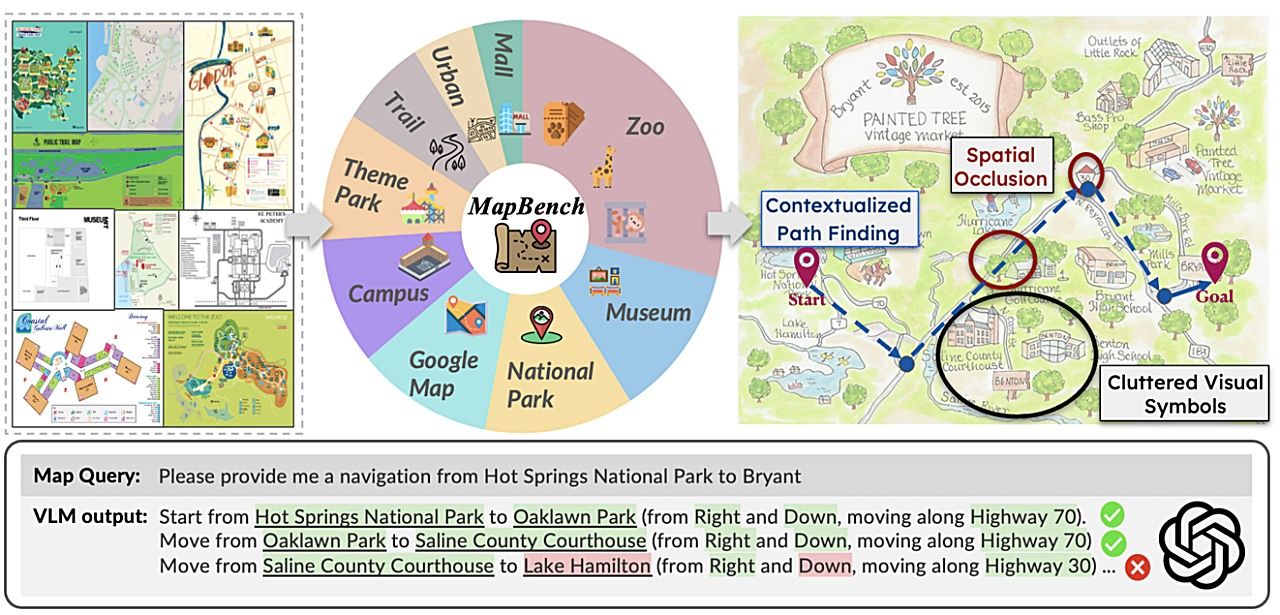
地図を読み取り、目的地までのルートを言語で説明できるAIは誕生するか──新ベンチマークMapBenchが明らかにした大規模視覚言語モデル(LVLM)の限界
マルチモーダルAI
ビジネス
2026
/
7
/
31
[FRI]
SpaceXAI、音声エージェント向けAI「Grok Voice Think Fast 2.0」発表 会話能力を強化、初回音声まで0.70秒
マルチモーダルAI
マルチモーダルAI
ビジネス
2026
/
6
/
26
[FRI]
Google、Gemini 3.5 Flashに画面操作機能「Computer Use」を統合 ブラウザ・モバイル・デスクトップ操作に対応
Google
AIエージェント
マルチモーダルAI
Google
AIエージェント
マルチモーダルAI
ビジネス
2026
/
5
/
20
[WED]
Google I/O 2026開催——最新基盤モデルGemini 3.5 Flash発表 24時間動く個人AIエージェント「Gemini Spark」とマルチモーダルモデルGemini Omniなども公開
Google
基盤モデル
AIエージェント
マルチモーダルAI
Google
基盤モデル
AIエージェント
マルチモーダルAI
ビジネス
2026
/
4
/
10
[FRI]
Meta、Superintelligence Labs初のAIモデル「Muse Spark」発表 Meta AIアプリとWebで提供開始
Meta
基盤モデル
マルチモーダルAI
Meta
基盤モデル
マルチモーダルAI
ビジネス
2026
/
1
/
14
[WED]
リコー、「文書×AI」を現場仕様に──Qwen2.5-VL-32B基盤、視覚データ60万枚でチューニング
マルチモーダルAI
基盤モデル
国内企業事例
マルチモーダルAI
基盤モデル
国内企業事例
ビジネス
2025
/
11
/
15
[SAT]
AIの"ゴッド・マザー" Fei-Fei LiのWorld Labs、マルチモーダル世界モデル「Marble」を一般公開──テキスト・画像・動画から“永続3Dワールド”生成
マルチモーダルAI
基盤モデル
マルチモーダルAI
基盤モデル
学術&研究
2025
/
10
/
7
[TUE]
Google ResearchとDeepMind、「StreetViewAI」を発表──視覚障害者がAIと対話しながらストリートビューを“歩く”
Google
マルチモーダルAI
Google
マルチモーダルAI
エンタメ&アート
2025
/
8
/
2
[SAT]
Runway、動画編集を一新するAIモデル「Aleph」発表──物体除去から新アングル生成まで
マルチモーダルAI
マルチモーダルAI
エンタメ&アート
2025
/
4
/
25
[FRI]
Adobe、生成AI基盤「Firefly」を刷新——画像・動画・音声・ベクターを統合し、OpenAI・Googleモデルも選択可能に
マルチモーダルAI
マルチモーダルAI
ビジネス
2025
/
4
/
17
[THU]
OpenAI、推論特化型の新モデル「o3」「o4-mini」を同時リリース——画像を“思考”に組み込み、全ツールを自律的に呼び出す
AIエージェント
OpenAI
マルチモーダルAI
基盤モデル
AIエージェント
OpenAI
マルチモーダルAI
基盤モデル
ビジネス
2025
/
4
/
7
[MON]
Meta、「Llama 4」発表 オープンウェイトで進化するネイティブマルチモーダルAIの可能性
Meta
マルチモーダルAI
基盤モデル
Meta
マルチモーダルAI
基盤モデル
学術&研究
2025
/
4
/
3
[THU]
地図を読み取り、目的地までのルートを言語で説明できるAIは誕生するか──新ベンチマークMapBenchが明らかにした大規模視覚言語モデル(LVLM)の限界
マルチモーダルAI
マルチモーダルAI
<
1
2
3
4
5
>
アクセスランキング
7日間
30日間
NEC、「AI社員」36体が働く自律型組織を公開 1on1やストレスチェックまで、人とAIで企業OSを再構築
Anthropic、Claude「Projects」を再設計 資料・会話をまとめる作業空間から、Claude Codeを並列指揮する“司令塔”へ
「もう復旧できない」AWS、中東データセンター攻撃から半年 バーレーンの一部データにアクセス不能
4
ローソン、生成AI発案の“なんだこりゃ?”商品3品を発売 レモンタルト×ピクルスなど、9月29日から
5
Meta、たまごっち風のAI端末「Muse Charm」発表 ポケットサイズで専用AIエージェントと会話
6
Google、Gemini搭載AIノートPC「Googlebook」の予約受付開始 899ドルから、5社が展開
7
OpenAI、数学者の独立組織「AGMAI」と連携でAI研究成果の公開に助言 暗号研究でもAstraで1941年のエニグマ解読の事例も
8
GrokのAIコンパニオン「Ani」がAnimatesへ 最上位プランは月額5800円
9
OpenAI、「GPT-6 Sol」「GPT-6 Luna」を公開 Astraの技術を低価格モデルに展開、API料金を引き下げ
10
元OpenAI研究者が率いるTypeSafe AI、プログラムの判断に特化した「Jev」を公開 文章を生成せず、選択肢や確率を返す
人気のタグ
AIエージェント
モビリティ×AI
半導体
基盤モデル
ロボティクス
マルチモーダルAI
EXPO2025
サイバーセキュリティ
近未来
日本政府
FOLLOW US
各種SNSでも最新情報をお届けしております
人気のタグ
AIエージェント
モビリティ×AI
半導体
基盤モデル
ロボティクス
マルチモーダルAI
EXPO2025
サイバーセキュリティ
近未来
日本政府