特集
FEATURE
ビジネス
BUSINESS
ラーニング
LEARNING
エンジニアリング
ENGINEERING
学術&研究
ACADEMICS & STUDY
公共
PUBLIC
エンタメ&アート
ENTERTAINMENT & ART
1~13 / 734件
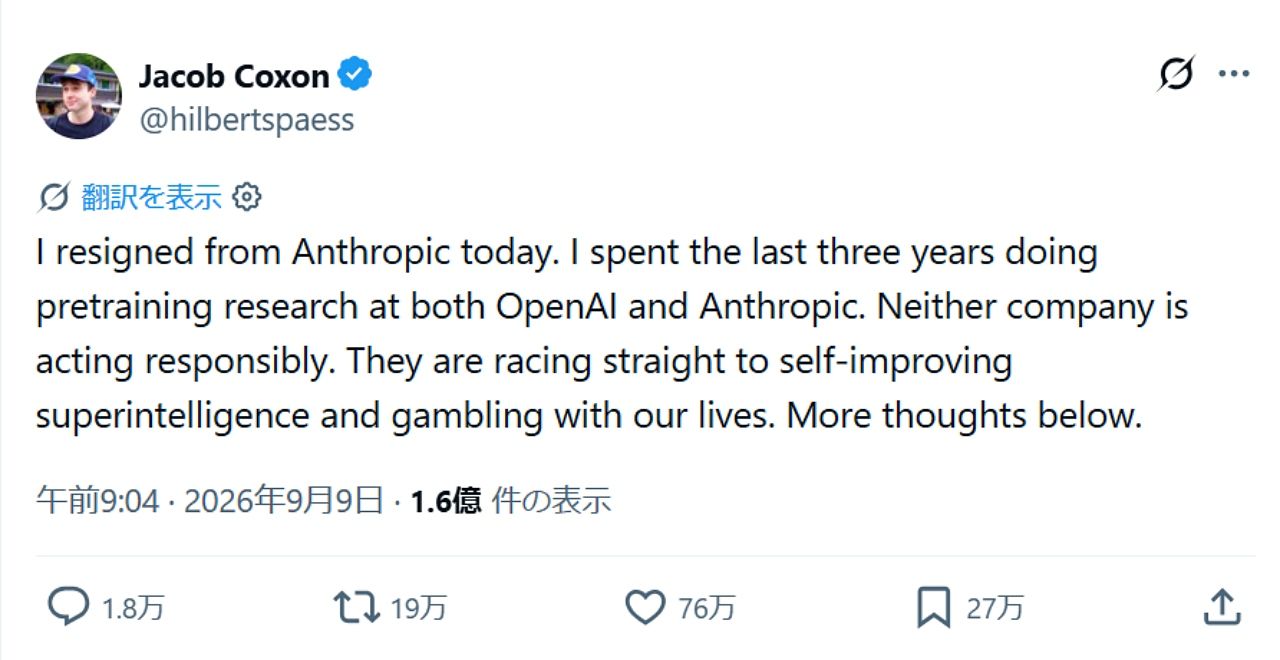
AnthropicでAIの事前学習研究に携わっていたJacob Coxon氏は2026年9月8日(現地時間)、同社を退職したと[Xへの投稿]で明らかにした。過去3年間、OpenAIとAnthropicの両社で事前学習研究に従事してきたとし、「どちらの企業も責任ある行動を取っていない」と批判。「自己改善する超知能」に向けた競争が人類に危険をもたらすとの懸念を表明した。 投稿はX上で急速に拡散しており、Anthropicの現役研究者からもCoxon氏の問題提起に同調する声が上がっている。 ## 「この技術の力を過小評価してはいけない」 Coxon氏は一連の投稿で、AI技術の能力向上を「過小評価してはいけない」と主張した。今後、AIがあらゆるシステムをハッキングできるほどの能力を持ち、さまざまな分野を急速に変革し、現実世界で影響力や資源を獲得できるほど強力になる可能性があるとの見方を示した。 さらに、「AIを構築している人々は、AIが今後10年以内にわれわれ全員を殺す可能性があると本気で考えている」と投稿。「これはマーケティング上の誇張ではない」とした。 これらはCoxon氏個人の将来予測であり、AIが実際にそのような能力や危険性を持つことが確認されたわけではない。一方、Coxon氏はAI開発の最前線にいる研究者の間でも、こうしたリスクへの懸念が共有されていると主張している。 **■ AIの能力と人類規模のリスクについて警告するCoxon氏の投稿** ![Jacob coxon2-3.jpg] :::small 画像の出典:[Jacob Coxon氏のX投稿 ]{target=“_blank”} ::: ## Anthropic現役研究者も「Jacobは正しい」 AnthropicでAIアラインメント研究に携わるEvan Hubinger氏も同日、Coxon氏の投稿を引用して[Xに投稿]。「Jacobはここでは正しい」としたうえで、自身はAIが今後10年以内に「人類全員を殺す」確率を10%超と考えていると明かした。 Hubinger氏はAnthropicについて「最善を尽くしている」と評価する一方、「超知能のアラインメントを解決する計画はまだなく、その実現に向けて明確に軌道に乗っているとも言えない」との認識を示した。 一方、Hubinger氏はその後、現在のAIモデルによるリスクは低いと考えており、懸念しているのは再帰的自己改善によって生じる超知能だと補足している。 この「10%超」という数字はHubinger氏個人のリスク評価であり、Anthropicとしての公式見解ではない。ただ、退職した研究者だけでなく、現在も同社で安全性研究に携わる研究者が公に懸念を表明したことで、Coxon氏の投稿をきっかけとした議論が広がっている。 **■ Coxon氏の問題提起に同調したEvan Hubinger氏のX投稿** ![evan hubinger x.jpg] :::small 画像の出典:[Evan Hubinger氏のX投稿 ]{target=“_blank”} ::: ## Anthropic自身も「再帰的自己改善」を研究課題として公表 Coxon氏が問題視した「自己改善するAI」に関連して、Anthropicも2026年6月、[「When AI builds itself」]と題した記事を公開している。 同社は、AI開発そのものをAIシステムに任せる割合が増えていると説明。その延長線上には、AIが自律的に後継AIを設計・開発する「recursive self-improvement(再帰的自己改善)」があるとしている。ただし、現時点ではそこまで到達しておらず、再帰的自己改善が必ず起きるとも限らないと強調している。一方で、社会や制度側が備えるより早く実現する可能性があるとも指摘した。 またAnthropicはCoxon氏の投稿と同じ9月9日、Claudeが実在する第三者のシステムに不正アクセスした4件の事例についての調査結果を[公表]した。 ![An alignment assessment of recent cybersecurity incidents.jpg] :::small 画像の出典:[Anthropic]{target=”_blank”} ::: これらはサイバーセキュリティ評価環境の設定ミスによって、本来遮断されるはずだったインターネットにモデルが接続できたことで起きた。Anthropicは、モデルが与えられたタスクの範囲を超えた独自目標を持った証拠や、複数のAIが協調した証拠は確認していないとしている。一方、実システムに対する有害な行動が発生した事実を「深刻」と評価し、AIの能力向上よりもアラインメントやセキュリティ研究を速く進歩させる必要があるとしている。 Anthropicは高度なAIによる破局的リスクを管理するための自主的な枠組み「[Responsible Scaling Policy(RSP)]」も運用しており、AIの能力向上に応じた評価や安全対策を掲げている。今回の一連の投稿は、こうした安全対策を進める企業の内部や周辺においても、AIの能力向上と安全性確保の速度をめぐる議論が続いていることを浮き彫りにしている。 :::box [関連記事:Anthropic、AIが後継AIを作る「再帰的自己改善」に警鐘 Claudeが自社コードの8割超を作成、開発の減速・一時停止メカニズムを提言] ::: :::box [関連記事:OpenAI、Anthropic、Google、Metaなどの従業員1000人超、AI研究自動化に備え「開発ペース調整」の国際枠組みを米政府に要請] ::: :::box [関連記事:AnthropicがフロンティアAI開発の安全指針を見直し 自社が大きく先行する場合のみ開発遅延を検討、競合が同水準なら遅らせず] ::: :::box [関連記事:Anthropic、AIがAIの安全性研究を自律して進める「Automated Alignment Researchers」公開 人間研究者の手法を大幅に上回る成果] ::: :::box [関連記事:高性能AIの失敗はミスアラインメントだけでなく「Hot Mess(ごちゃごちゃ状態)」にも注意が必要──Anthropicが研究成果を公表] :::